机器学习 · 计算机视觉
付彦伟 Yanwei Fu
我的研究围绕人工智能的核心问题:如何让机器在有限数据下学会新概念、迁移知识并可靠泛化。以小样本学习与统计方法为基础,我将这一主线推进至生成模型、三维视觉、具身智能与脑解码,连接学习理论、视觉感知和真实世界应用,并通过国际合作探索机器学习在气候科学等领域的价值。
国家自然科学奖二等奖(第四完成人) · IEEE ICME 最佳论文奖 · CVPR 最佳论文奖入围与候选 · Wiley Top Viewed Article
连续三年组织 CVPR Tutorial 并作教程报告
2022–2024 · 查看主题与报告 →
国家与省部级科研奖励
- 2023
- 2023
- 2023
- 2022
产业界认可
- 2021 年度优秀技术成果奖华为上海研究所
- 腾讯“犀牛鸟计划”访问学者Tencent Rhino-Bird Visiting Scholar
研究方向
让模型从少量观察中获得新概念、迁移已有知识并实现可靠泛化,是贯穿我研究的核心命题。围绕“学会学习”,我从统计基础出发,推动视觉智能与具身智能中的方法创新。
小样本学习与统计基础
研究元学习、稀疏性与因果学习,建立有限监督条件下可靠泛化的方法与理论基础。
生成模型与三维视觉
研究扩散模型、可控视频生成,以及稀疏观测下的三维与四维重建。
具身智能
研究视觉引导的机器人操作、视觉—语言—动作模型、示范学习,以及第一视角与跨视角理解。
多模态学习与脑解码
fMRI 大规模预训练、fMRI-to-3D 脑解码,以及面向科研社区的 fMRI/EEG 开放数据集。
代表性论文
完整论文列表 →研究亮点
-
CVPR 2026脑解码
CineBrain: A Large-Scale Multi-Modal Audiovisual Brain Dataset for Brain-Conditioned Video Generation
Jianxiong Gao, Yichang Liu, Baofeng Yang, Jianfeng Feng, Yanwei Fu
首个在视听观看过程中同步采集 fMRI 与 EEG 的大规模脑数据集。
-
ICML 2026可靠生成
Conformal Reliability: A New Evaluation Metric for Conditional Generation
Yachen Gao, Xinwei Sun, Yikai Wang, Ye Shi, Jingya Wang, Jianfeng Feng, Yanwei Fu
-
CVPR 2026视频世界模型
VerseCrafter: Dynamic Realistic Video World Model with 4D Geometric Control
Sixiao Zheng, Minghao Yin, Wenbo Hu, Xiaoyu Li, Ying Shan, Yanwei Fu
据我们所知,这是首个通过显式 4D 几何协同控制相机与多物体运动的动态真实视频世界模型。
-
CVPR 2026机器人
ActiveVLA: Injecting Active Perception into Vision-Language-Action Models for Precise 3D Robotic Manipulation
Zhenyang Liu, Yongchong Gu, Yikai Wang, Xiangyang Xue, Yanwei Fu
据我们所知,首次将任务驱动的虚拟视角选择与主动三维放大共同融入粗到细的 VLA 操作框架。
-
ICML 2025扩散桥
UniDB: A Unified Diffusion Bridge Framework via Stochastic Optimal Control
Kaizhen Zhu, Mokai Pan, Yuexin Ma, Yanwei Fu, Jingyi Yu, Jingya Wang, Ye Shi
-
CVPR 2024光流估计
MemFlow: Optical Flow Estimation and Prediction with Memory
Qiaole Dong, Yanwei Fu
据我们所知,首次统一可读写运动记忆、分辨率自适应注意力与未来光流预测;投稿时在 1080p Spring 基准排名第一。已被 PTLFlow 集成,并在 MFTIQ 点跟踪研究中得到下游复用。
-
ICLR 2024三维重建
MVSFormer++: Revealing the Devil in Transformer's Details for Multi-View Stereo
Chenjie Cao, Xinlin Ren, Yanwei Fu
-
CVPR 2022
TPAMI 2023图像修复ZITS: Incremental Transformer Structure Enhanced Image Inpainting with Masking Positional Encoding
Qiaole Dong, Chenjie Cao, Yanwei Fu
期刊扩展版
ZITS++: Image Inpainting by Improving the Incremental Transformer on Structural Priors
Chenjie Cao, Qiaole Dong, Yanwei Fu
已应用于华为 Mate 60 的 AI 消除功能。ZITS 系列将结构感知图像补全带入手机照片编辑;ZITS 同时被开源图像编辑工具 IOPaint 集成。
-
CVPR 2021语义分割
SETR: Rethinking Semantic Segmentation from a Sequence-to-Sequence Perspective with Transformers
Sixiao Zheng, Jiachen Lu, Hengshuang Zhao, Xiatian Zhu, Zekun Luo, Yabiao Wang, Yanwei Fu, Jianfeng Feng, Tao Xiang, Philip H.S. Torr, Li Zhang
据我们所知,SETR 首次采用纯视觉 Transformer 编码器,将语义分割建模为序列到序列预测任务。它在编码器各层建模全局上下文,无需逐级降低空间分辨率。
连续三年组织与报告
CVPR 学术教程 · 2022–2024
连续三年担任 CVPR Tutorial 联合组织者和报告人,在 CVPR 2022、2023、2024 作开场介绍与教程报告,分享从稀疏学习、小样本学习到以对象为中心的视觉表征的研究方法与应用。
-
CVPR 2024
Object-centric Representations in Computer Vision
报告:More Real-world Applications by Object-centric Representations
-
CVPR 2023
Few-shot Learning from Meta-Learning, Statistical Understanding to Applications
报告:Few-shot Learning by Statistical Methods (与 Yikai Wang 联合报告)
-
CVPR 2022
Sparse Learning in Neural Networks and Robust Statistical Analysis
报告:Introduction;Sparse Learning in Noisy Data Detection (与 Yikai Wang 联合报告)
学术服务
- Action Editor · 责任编辑Transactions on Machine Learning Research
- 长期担任领域主席(Area Chair)NeurIPS · ICML · ICLR
- 长期担任高级领域主席(Senior Area Chair)AAAI
- CVPR 学术教程联合组织者与报告人2022–2024 · 连续三年
个人荣誉与人才计划
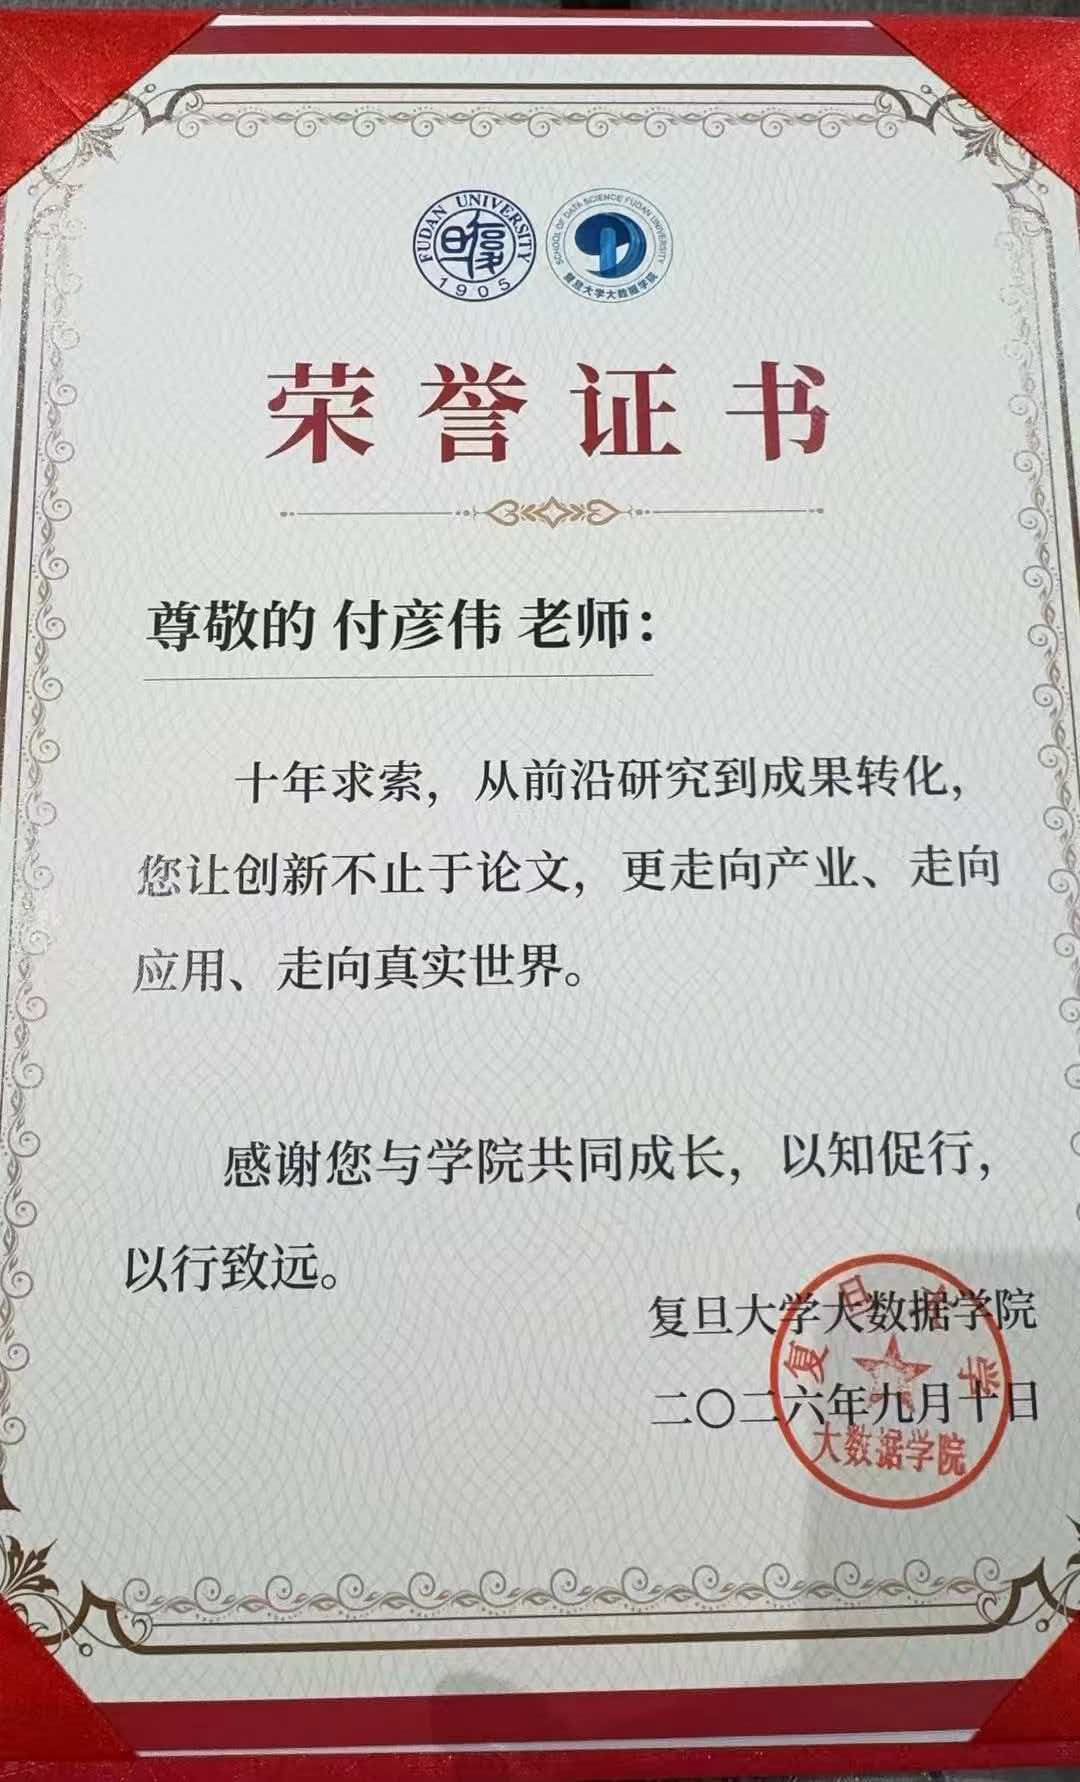
- 复旦大学大数据学院十周年荣誉证书2026 · 复旦大学大数据学院查看证书 ↗
- 英国计算机学会会士(FBCS)2022 · British Computer Society
- 国家青年千人计划2018
- 上海市东方学者2017
- 澳大利亚研究理事会 DECRA Fellow2016 · Australian Research CouncilDiscovery Early Career Researcher Award
- 国家优秀自费留学生奖学金2014
学术经历
复旦大学教授大数据学院 · 2023 年 12 月起任教授
复旦大学青年副研究员、青年研究员大数据学院 · 先后任职
Disney Research Pittsburgh 博士后研究员合作导师:Leonid Sigal
伦敦玛丽女王大学计算机视觉博士导师:Tao Xiang、Shaogang Gong
南京大学计算机科学硕士
代表性论文荣誉
论文奖励与学术认可
-
2026
最佳论文奖候选 CVPR 2026 · Oral / 口头报告
会议官方日程 ↗ -
2026
Most Influential CVPR 2021 Paper · 最具影响力论文 Paper Digest · 第 4 名
SETR: Rethinking Semantic Segmentation from a Sequence-to-Sequence Perspective with Transformers
2026-03 版 · 在 CVPR 2021 年论文中排名第 4;在 2022-02 版中排名第 2。
-
2026
arXiv 计算机视觉最具影响力论文 Paper Digest · 第 11 名
SETR: Rethinking Semantic Segmentation from a Sequence-to-Sequence Perspective with Transformers
2026-04 版 · 在 2020 年 arXiv cs.CV 论文中排名第 11。该论文于 2020 年首发预印本,后发表于 CVPR 2021,为同一项工作。
arXiv 计算机视觉官方榜单 ↗ -
2026
Most Influential IJCAI 2018 Paper · 最具影响力论文 Paper Digest · 第 4 名
Soft Filter Pruning for Accelerating Deep Convolutional Neural Networks
2026-03 版 · 在 IJCAI 2018 年论文中排名第 4;在 2021-02 版中排名第 1。
-
2025
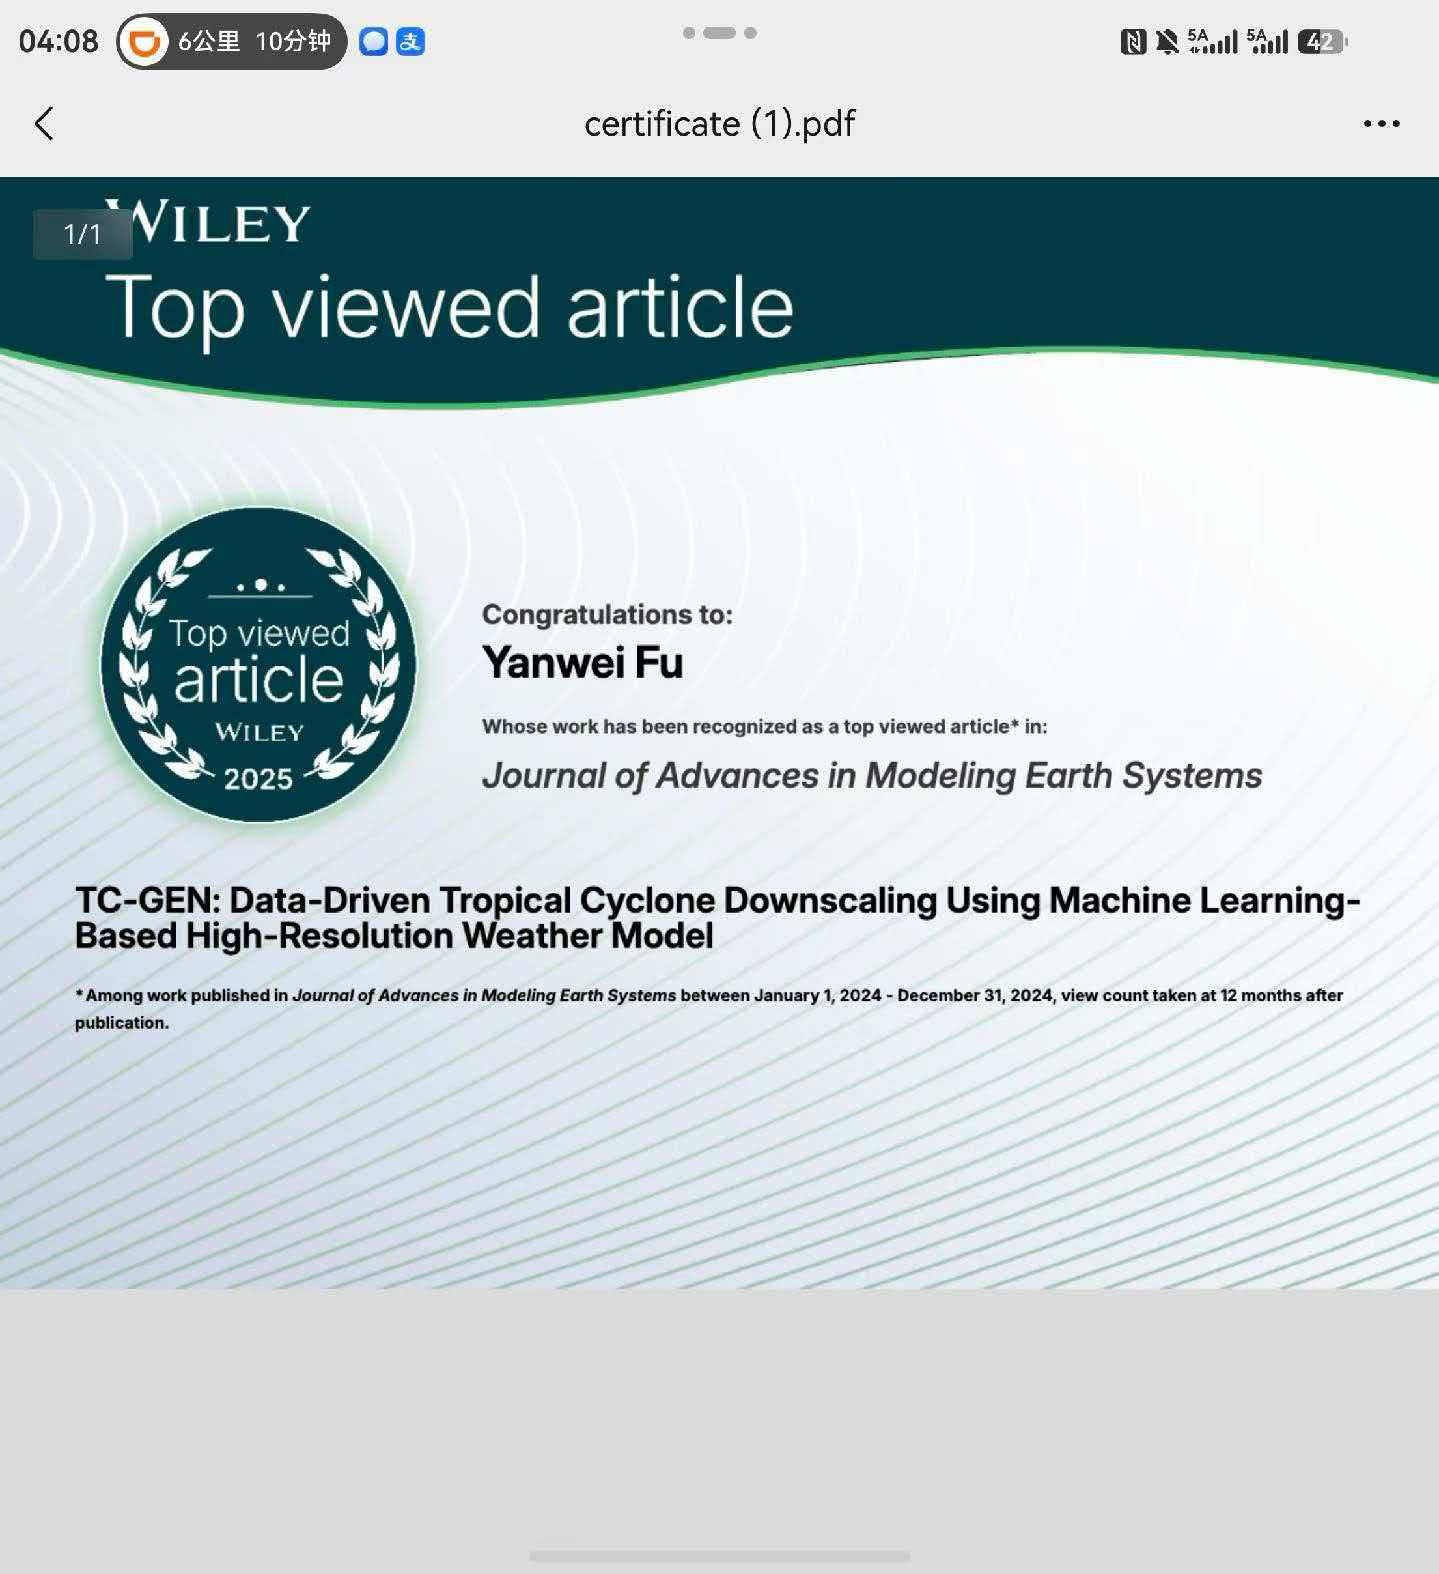
Top Viewed Article · 高阅读量论文 Wiley · Journal of Advances in Modeling Earth Systems(JAMES)
与麻省理工学院 Kerry Emanuel 教授(美国国家科学院院士、美国艺术与科学学院院士),以及斯坦福大学 Noah S. Diffenbaugh 和 Eran Bendavid 合作完成。
Wiley 于 2025 年授予认证:在 JAMES 2024 年发表的论文中获评 Top Viewed Article,阅读量统计截至论文发表后 12 个月。
-
2025
TMLR Journal-to-Conference(J2C)认证 ICML 2026 · 海报展示
Repositioning the Subject within Image
2024 年 11 月发表于 TMLR · 2025 年 10 月获 J2C 认证 · 入选 ICML 2026 Journal-to-Conference Track 展示。
-
2025
杰出长论文奖 ICLR 2025 DeLTa 工作坊
A Unified Diffusion Bridge Framework via Stochastic Optimal Control
官方获奖公告 ↗ -
2024
Highest Impact Award · 最高影响力奖 IEEE Computer Society Biometrics Workshop
When Person Re-Identification Meets Changing Clothes
发表于 CVPR 2020 Biometrics 工作坊 · 2024 年获奖
合作作者获奖记录 ↗ -
2023
青年优秀论文奖 世界人工智能大会(WAIC)
SETR: Rethinking Semantic Segmentation from a Sequence-to-Sequence Perspective with Transformers
共同署名成果 · 获奖人:郑思晓(Sixiao Zheng)
官方获奖名单 ↗ - 2019
-
2019
最佳论文奖入围(Finalist) CVPR 2019 · Oral / 口头报告
Image Deformation Meta-Networks for One-Shot Learning
官方获奖公告 ↗
学术荣誉与研究报道
全球人工智能人才榜 TOP100 · 2025
同时入选中国人工智能人才榜 TOP100。榜单由联合国工业发展组织投资和技术促进办公室(中国·北京)与东壁科技数据联合发布。
学术白皮书贡献
-
起草《科学智能白皮书2025》具身智能部分
我负责《科学智能白皮书2025》具身智能部分的起草,梳理领域进展、关键科学问题与突破路径。白皮书由复旦大学、上海科学智能研究院与施普林格·自然旗下的自然科研智讯(Nature Research Intelligence)合作发布。
产业应用
-
ZITS 图像修复算法落地华为 Mate 60 的 AI 消除功能
我们团队研发的 ZITS 系列图像修复算法应用于华为 Mate 60 手机的 AI 消除功能,将结构感知图像补全研究转化为日常照片编辑体验。
三维重建与 3D 生成大模型
-
StreetUnveiler:将拥挤行车观测转化为可编辑的空街景三维表示
StreetUnveiler 通过语义感知 2D Gaussian Splatting 与逆时序补全,移除停靠车辆等临时遮挡物,重建可编辑的空街景三维表示。方法定位真正缺失的区域,利用后续更近、更清晰的视图指导早期画面补全,提升时序一致性,并支持网格提取,为街景编辑与仿真研究提供基础。
发表于 ICLR 2025,并获邀在 SIGGRAPH Asia 2025 展示。官方日程将该工作列入 的 Invited: Posters/邀请海报环节。
-
DeepSFM 系列:首创双代价体深度光束法平差
据我们所知,DeepSFM 首次以相互耦合的深度代价体(D-CV)和位姿代价体(P-CV)构建深度光束法平差框架,在同一网络中显式融合光度一致性与几何一致性,交替迭代细化场景结构和相机运动。工作获 ECCV 2020 Oral,并进一步扩展发表于 IEEE TPAMI。
MaFreeI2P(2024)明确将 DeepSFM 作为图像—点云配准方法的启发来源之一。该论文在引言中引用 DeepSFM 的 TPAMI 版本,以其代价体方法的成功应用为依据,引出基于位姿的代价体设计。
第三方技术解读重点肯定了少视图、初始化噪声及图像质量变化条件下的鲁棒性。TSUKAMOTO Kenji 在 的日本计算机视觉读书会专题报告中讨论了这些优势,同时分析了位姿假设生成所引入的任务相关参数。
被纳入 Gerard Pons-Moll 在图宾根大学开设的 2025 年三维视觉课程。第九讲将 DeepSFM 与 VGGSfM 并列,作为“端到端可学习 SfM 流程”介绍。此外,3D视觉工坊将其收录于 ECCV 2020 优秀论文汇总,电子工程专辑平台转载的自动驾驶行业综述也引用了该工作。
-
MVSFormer 系列:预训练视觉 Transformer 推进多视图三维重建
基于 2022 年 5 月提交的结果,MVSFormer 在 Tanks and Temples 的 Intermediate 与 Advanced 两组中,均位列当时已发表方法第一。 平均 F-score 分别为 66.37 和 40.87。
据我们所知,MVSFormer 是首个系统研究预训练视觉 Transformer 如何增强多视图立体重建的工作。MVSFormer++(ICLR 2024)进一步融入 DINOv2 表征与跨视图信息,优化 Transformer 设计,持续提升重建精度与泛化能力。
系列研究获 TMLR 官方周报介绍,智源社区与 HyperAI 提供了论文介绍。
-
Argus-3D:36 亿参数规模的 3D 原生生成大模型
据我们所知,Argus-3D 是学术界首个扩展至 36 亿可训练参数的 3D 原生形状生成大模型,于 首次公开。与智源研究院等合作提出,汇集约 90 万个公开 3D 物体,直接学习三维几何的离散表征与自回归生成先验,支持多模态条件下的三维形状生成。
原论文报告其为当时最大规模的 3D 形状生成模型。智源社区于 刊发专题介绍,扩展预印本于 公开。
-
Pixel2Mesh 系列:从单张 RGB 图像直接生成三维网格
Pixel2Mesh 是首个能够从单张彩色图像(RGB)直接端到端生成 3D 三角网格(Mesh)的深度学习框架。突破以点云或体素作为中间表示、再转换为网格的流程,直接输出可用于渲染和几何处理的网格模型。
Pixel2Mesh++(ICCV 2019)进一步实现多视角网格生成与精细化,提升几何细节和跨视角一致性。
系列代表作 Pixel2Mesh 连续三年(2022–2024)被斯坦福大学 CS231n 课程讲授。课程在三维视觉章节中,以 Pixel2Mesh 讲解从单张 RGB 图像重建三角网格的方法。
PaperWeekly 分别于 和 刊发专题解读,介绍单图直接生成网格的突破及后续多视角扩展。
图像修复与多视图编辑
-
MVInpainter:连接二维图像修复与三维编辑
据我们所知,MVInpainter 首次通过多视图一致修复模型连接二维与三维场景编辑。它结合视频先验与外观引导,将参考图像中的编辑一致传播到多个视角,在无需显式相机位姿条件的情况下支持物体移除、插入与替换。
SplatFlow(CVPR 2025)使用 MVInpainter 官方实现进行三维编辑的定性比较。这体现了该工作在后续多视图一致场景编辑研究中的参考与复用价值。
-
LeftRefill:首创“左侧参考、右侧生成”的跨视角修复范式
据我们所知,LeftRefill 首次将文生图扩散模型用于跨视角参考图引导的端到端图像修复,提出“左侧参考、右侧生成”的统一画布范式。在参考引导修复任务中,无需额外图像编码器或复杂的显式三维配准流程,仅学习约 5 万至 6.5 万个提示参数,即可激活大模型的跨图结构与纹理关联能力;同一框架还支持新视角合成与多视角一致生成。
CorrFill(WACV 2025)明确将 LeftRefill 评价为当时的先进方法(SOTA),并沿用其左右拼接输入及跨图注意力设计。在该论文对四个未经 CorrFill 增强的原始基线进行的比较中,LeftRefill 在 RealEstate10K、MegaDepth 两个数据集上的 PSNR、SSIM、LPIPS 三项指标均为最佳;其公开实现也复用了 LeftRefill 的代码和已学习提示嵌入。
清华大学 AIR、香港科技大学(广州)等团队的 Structured-NeRF(ECCV 2024)直接将 LeftRefill 用于三维场景重建。该研究结合预训练的 LeftRefill 与 LaMa 预测遮挡区域外观,作为背景神经辐射场的颜色监督,将其能力用于可交互的三维场景编辑。
-
ZITS 系列:以结构先验引导图像补全
结合全局结构恢复与纹理生成,连贯地补全图像缺失区域。ZITS++ 进一步增强纹理恢复,并系统分析不同结构先验在高分辨率图像修复中的作用。
ZITS 系列已通过华为 Mate 60 的 AI 消除功能进入实际手机应用;ZITS 也被 IOPaint 集成。SmartEraser(CVPR 2025)在 RORD-Val、DEFACTO-Val 和 Syn4Removal-Val 三套物体移除基准上评测 ZITS++。
光流、立体匹配与运动理解
-
PPMStereo:以自适应记忆提升视频立体深度的时序一致性
据我们所知,PPMStereo 首次将高质量记忆机制引入动态立体匹配。其 Pick-and-Play Memory 先选择信息充分的参考帧,再自适应加权聚合,以紧凑记忆建模长程时空关系,减少视频深度估计的闪烁。
在相同 Dynamic Replica+SceneFlow 训练设置下,相比 BiDAStereo,Sintel clean/final 的时序端点误差(TEPE)分别降低 17.3%/9.0%。基础模型将对应误差从 0.75 降至 0.62、从 1.22 降至 1.11,改善时序一致性与计算开销之间的折中。
-
MemFlow:首次统一可读写运动记忆、自适应注意力与未来光流预测
据我们所知,MemFlow 首次将可读写的历史运动记忆、分辨率自适应注意力与未来光流预测纳入同一在线光流框架。它既能利用已观测帧估计当前运动,也能在下一帧到来前预测未来光流,将光流从逐对匹配推进到持续记忆驱动的运动理解。论文记录 MemFlow 投稿时在 1080p Spring 基准排名第一。
已被 PTLFlow 集成,并被 MFTIQ(WACV 2025)接入为可替换的光流模块。MFTIQ 在 TAP-Vid DAVIS 上评估这一配置的点跟踪效果,并在公开代码中包含适配后的 MemFlow 实现。
-
MatchFlow:首次以前置几何匹配预训练增强光流泛化
据我们所知,MatchFlow 首次将真实静态场景的几何图像匹配作为光流特征学习的前置预训练任务,扩展了传统光流课程学习流程。通过先学会跨视角几何对应,再学习复杂物体运动,开辟了利用大规模真实匹配数据提升光流泛化的训练路径。CVPR 2023 论文报告,相比 GMA,Sintel clean 测试误差降低 11.5%,KITTI 测试误差降低 10.1%。
PTLFlow 已纳入 MatchFlow 及其基于 RAFT 的变体,通过统一推理和评测接口提供预训练模型,便于与其他光流方法比较和复用。
可控视频生成与开源生态
-
Uni3C:无需联合训练的三维相机与人体协同控制 · SIGGRAPH Asia Oral
据我们所知,Uni3C 首次通过统一三维世界坐标中的场景点云与人体表示,在无需相机与人体控制联合训练的条件下,实现可独立指定、又几何协调的相机轨迹与人体动作控制。它将即插即用的点云相机控制器与人体动画模型组合,使镜头运动与人物动作在同一三维世界中准确协同。
SIGGRAPH Asia 2025 Oral/口头报告。论文于 在香港的 Technical Papers 专题作现场报告;下方相册收录五张报告与会场照片。
Uni3C 的相机控制模块已纳入 ComfyUI 原生支持,随官方 v0.29.0 版本发布,为 Wan 视频模型提供相机控制。ComfyLab 通过实际环绕运镜工作流介绍了这一集成。
-
VidCRAFT3:统一控制相机、物体与光照的视频生成
VidCRAFT3 是首个在图生视频(Image-to-Video,I2V)领域,支持相机运动、物体运动与光照方向独立及联合控制的统一扩散模型框架,在同一模型中精细控制视点、场景动态与光照。
研究获日文技术博客 D × MirAI 及 The Moonlight 论文解读介绍。
-
VerseCrafter:四维几何控制,让视频生成精准运镜、协同控物
据我们所知,VerseCrafter 是首个通过显式 4D 几何协同控制相机与多物体运动的动态真实视频世界模型。与腾讯 ARC Lab 等合作研发,并提供 Blender 交互界面,便于设计运镜和物体运动。
研究获《机器之心》专题报道,文章可通过该媒体在腾讯云的同步发表页阅读。
具身智能
-
Pose-VLA:首次以统一位姿 token 连接三维定位与动作预训练
据我们所知,Pose-VLA 首次以统一相机坐标系中的位姿 token 为共同接口,将非机器人三维定位数据与机器人运动轨迹纳入同一套 VLA 预训练框架,再通过面向具体机器人的动作对齐迁移空间先验。它将物体位姿与末端执行器运动统一为离散表征,先学习通用三维定位、再学习机器人轨迹,最后对齐具体动作空间,弥合语义识别与精细控制所需三维状态理解之间的鸿沟。
我们向具身智能社区传递的核心判断是:3D 空间理解对具身智能大模型至关重要。该工作发表于 Robotics: Science and Systems(RSS)2026,在真实机器人实验中,每项任务仅用 100 条示教即可验证对多种物体的泛化能力。
在我看来,近期 GPT-6 Astra 的机器人演示也从另一条技术路径呼应了这一判断:Wentao Zhu 的技术观察记录了模型通过底层机器人 SDK 规划双臂协调、主动视觉与错误恢复的演示,进一步凸显空间理解与行动相结合的价值。
-
ActiveVLA:首次融合虚拟视角选择与主动三维放大的 VLA
据我们所知,ActiveVLA 首次在粗到细的 VLA 感知—动作框架中,同时融入任务驱动的虚拟视角选择与主动三维放大,让模型主动决定“从哪里看、看得多细”,再执行精细操作。针对固定视角输入中关键几何信息被遮挡或过于细小的问题,它使视觉感知过程本身成为可随任务调整的一环。
我们提出原创的粗到细感知框架,将任务驱动的虚拟视角选择与主动三维放大相结合:先定位关键三维区域,再合成信息更充分的视图、放大局部几何细节,最后预测动作,突破固定视觉输入在视角与分辨率上的限制。
我是这篇 CVPR 2026 论文的共同通讯作者。RLBench、COLOSSEUM、GemBench 基准评测与真实机器人演示表明,该方法提升了复杂、遮挡场景下操作的精度与鲁棒性。
-
OCRA:三维与触觉共同驱动的人机技能迁移
OCRA 将以物体为中心的三维几何与触觉先验统一用于人到机器人的技能迁移,让机器人同时学习物体怎样移动、接触时怎样用力。方法从多视角 RGB 视频重建物体运动,以百万级触觉图像预训练的编码器提供接触信息,将人类示范学习拓展到易碎物体操作、重量与纹理分类。
每项任务仅需 20–40 段人类示范;在三项视触觉任务中,加入触觉将平均成功率从 40% 提升至 90%。这一对比覆盖易碎杯搬运、重量分类和纹理分类,每项进行 10 次真实机器人测试;完整评估共覆盖七项操作任务。
获南加州大学 USC Viterbi 工程学院 ICRA 2026 官方研究专题介绍。该校会议报道在 Research Spotlights 中介绍了 OCRA 的触觉学习与人到机器人动作迁移。
-
SCOOP’D:零真实示教的液固混合选择性舀取
SCOOP’D 无需真实机器人示教或额外策略微调,仅凭仿真生成的示范,就能让真实机器人从液固混合物中选择性舀取指定目标。两阶段扩散策略分别生成勺具的初始位姿与舀取动作,并通过视觉跟踪引导执行,应对目标移动与遮挡。
共开展 465 次真实机器人测试;其中,240 次 Level 1 测试按“只舀出目标、不夹带干扰物”的严格标准,成功率达到 82.5%。实验验证了对不同物体、容器与勺具的泛化,并进一步测试不同液体、多目标、移动物体及视角变化。
获南加州大学 USC Viterbi 工程学院 ICRA 2026 官方研究专题介绍。该校报道介绍了液固混合物操作,以及将仿真中学到的技能迁移到真实环境的研究。
-
τ₀-WM:与智元合作的统一视频—动作具身世界模型
我参与了上海创智学院与智元机器人具身研究中心联合发布的 τ₀-WM 研究。该模型利用约 27,300 小时的机器人与人类交互数据进行预训练,将视频预测、动作生成与行动后果评估统一起来,使机器人能够在实际执行前预测、评估并修正候选动作。
中国工程院院士何友在第四届(2026)上海计算机视觉大会《智能无人系统发展前沿》报告中介绍 τ₀-WM,其报告幻灯片称该工作为“当前全球最大规模的开源预训练具身世界模型”,强调了当时的预训练数据规模。
研究获得《文汇报》/上观新闻、《新民晚报》及量子位专题报道,介绍模型在执行前预判行动后果、实现跨任务泛化的能力;模型权重与代码已开源。
-
ST4VLA/InternVLA-M1:我的学生 Junqiu Yu 的空间引导机器人学习研究
这是我的学生 Junqiu Yu(喻俊秋)与合作者共同完成的工作。Junqiu 是 ST4VLA(ICLR 2026)的共同第一作者,也是相关 InternVLA-M1 开源项目的核心贡献者;我共同署名 ST4VLA,并参与了 InternVLA-M1 研究。
空间引导训练将“在哪里行动”与“如何行动”连接起来。先通过点、框与轨迹等空间定位任务建立可迁移的空间先验,再以空间提示引导动作训练,在学习机器人控制的同时保留空间理解能力,提升对新物体、新指令和长时程操作任务的泛化。
相关 InternVLA-M1 模型已被独立团队用于后续机器人学习研究。南加州大学 Ψ₀ 人形机器人研究微调其预训练权重并开展实机评测,DOMINO/PUMA 工作也将其微调后用于动态操作基准,体现了模型被外部研究复用与评测的具体价值。
-
TransSoft:低成本、径向可重构的多模式软体抓取手
TransSoft 将软体抓取与径向构型重构结合,适应不同尺寸、形状和材质的物体。通过调整手指长度与夹爪宽度,同一只手可采用向心、爪式、离心、反爪式、窄钩和宽钩六种模式;真实物体演示展示了多样的抓取与钩取任务。
这项工作的实用优势在于将机械结构的适应性与便捷的构建方式结合。构型调整让同一只手以多种方式与物体建立接触。作者报告,采用现成组件的机械手原型成本约 200 美元、组装约需三小时,为低成本具身操作研究提供了实用的硬件思路。
-
视触觉 AI 传感器:WAIC 2025 向国务院总理李强现场演示
我作为团队成员参与研发的自适应视触觉 AI 传感器,在 WAIC 2025“镇馆之宝——WAIC 里机器人技能大舞台”的核心中央展区进行了现场 demo,并向国务院总理李强现场演示,展示机器人对豆腐、果冻等易碎物体的精细抓取能力。
《中国科学报》/科学网及《文汇报》/上观新闻均就这项技术采访了我。《文汇报》于 的 WAIC 现场报道介绍了视触觉感知算法;《中国科学报》介绍抓果冻、舀汤圆等演示,以及精细分拣与精密装配中的应用前景。
-
TriVLA:System 1/2/3 三系统中世界模型与 VLA 的深度融合
据我们所知,TriVLA 首次在统一的 System 1/System 2/System 3 三系统 VLA 架构中,将世界模型与视觉语言动作模型进行深度融合。于 首次公开的版本中,System 1 负责实时动作生成,System 2 提供视觉语言理解与世界知识,System 3 通过视频世界模型预测未来动态;动作策略联合使用后两者的表征,使机器人既能理解复杂意图,也能预判操作后果,完成长时程任务。
的 v3 更新稿进一步明确情景世界模型的形式化:首个在统一三系统 VLA 架构中形式化构建情景世界模型的框架,支撑复杂指令理解和长时程机器人操作。
研究获得深蓝学院视频解读,以及 Moonlight 和 CSDN 开发者社区的论文评述与技术解析。
-
CAP-Net:从关节部件 RGB-D 感知到真实机器人操作
CAP-Net 获选 CVPR 2025 Highlight,将精细部件感知与真实机器人操作相连接。 据我们所知,这是首个以完整物体 RGB-D 为输入,在端到端单阶段网络中同时预测部件语义、实例中心与规范化部件坐标的方法,保留整体上下文来估计未见可动部件的位姿与尺寸。
配套的 RGBD-Art 数据集 包含 6.3 万张带部件标注的逼真 RGB-D 图像,并模拟真实传感器噪声。方法与数据共同支持从合成训练迁移到真实机器人操作,以消费级 RGB-D 相机感知关节部件。
后续上海交通大学研究沿用了其特征提取设计和数据集,并将 CAP-Net 纳入评估基线。 2026 年的 Revisiting Articulated Parts Perception in Robot Manipulation 采用 CAP-Net 的 SAM2 与 FeatUp 特征流程,在 RGBD-Art 上评测,并在部件感知及真实机器人操作中与 CAP-Net 进行比较。
-
SparseGrasp:稀疏 RGB 视角下的三维语义高斯抓取
SparseGrasp 使用稀疏 RGB 观测,将开放词汇语言定位连接到机器人抓取。方法以 DUSt3R 初始化三维语义高斯场景表示,通过 PCA 压缩视觉语言特征,再由结合高斯特征的抓取模型将目标定位衔接到真实操作。
其优点是减少相机视角数量,并高效复用场景几何。论文的静态场景实验中,仅用三个 RGB 视角,70 次抓取成功 55 次;使用十七个视角的 F3RM 和 LERF-TOGO 分别成功 38 次和 33 次。初始重建约需四分钟,已有物体移动后的渲染比较位姿更新约需 200 毫秒;新增或移除物体时需要重新初始化。
《中国图象图形学报》2026 年综述讨论了 SparseGrasp 通过开放词汇查询识别长尾物体的特点,将其纳入语义三维感知与机器人交互相连接的应用。
-
TaMMa:稀疏观测下的跨场景精细移动操作
TaMMa 面向移动操作中的关键难题:让机器人仅凭稀疏观测,就能跨多个子场景完成精细的组合任务。工作将语义三维高斯场景先验、扩散式深度补全与高斯场景修复相结合,从粗定位目标和底盘导航逐步获得精确操作位姿,并在执行前表示预期的物体布局,在真实机器人上完成跨工作区域的倒水、堆叠与整理。其价值在于将可扩展的场景表示与精细操作衔接起来。
2025 年综述《Towards a Unified Understanding of Robot Manipulation》在移动操作章节中专门讨论 TaMMa,将其作为利用三维场景建模辅助操作的工作,介绍稀疏高斯定位与深度补全如何支持准确的目标位姿估计。
-
Polaris:2024 年公开展示 GPT 调用技能库完成长程复杂任务
Polaris 于 2024 年首次向学术界公开展示其“基础能力封装为 skill 技能库,再由 GPT 大模型调用”的机器人操作框架。框架将感知定位、抓取、放置、递交、堆叠与整理等能力组织为可组合的技能,由 GPT-4 理解开放式指令并协调调用,结合精确六自由度位姿与操作规划,在真实机器人上完成多步骤、长程复杂任务。
Polaris 面向语言驱动机器人的关键问题:如何将开放式交互落实为物理操作所需的精确几何信息。工作提出合成到真实的类别级位姿估计流程,仅用渲染数据训练位姿模型,再与 GPT-4 和基于位姿的操作规划器结合,在降低真实位姿标注需求的同时,支持真实桌面场景中的堆叠、整理与组合操作,将语言意图理解与三维动作执行衔接起来。
真实机器人实验展示了堆叠瓶子、整理工作台,以及场景受到碰撞后继续交互并完成组合任务。后续《Text-guided RGB-P grasp generation》研究在相关工作中讨论 Polaris,介绍其结合大语言模型与合成到真实视觉定位、支持开放式交互操作的思路。
-
PourIt!:开创用于机器人闭环倾倒的单图三维液流感知
据我们所知,PourIt! 首次在不依赖时序信息的条件下,从单张图像感知并近似重建倾倒液流的三维形状。方法结合估计的源容器位姿、液体掩码与重力对齐的几何假设,在无需直接测量液体深度的情况下提供视觉反馈;仅用图像级“有/无液流”标签学习感知,降低逐像素标注成本,并在真实 Franka 机器人的倾倒实验中以 10 Hz 运行。
独立开源项目 IsaacLabPouringExtension 在项目说明中明确使用 PourIt 进行图像处理,探索结合强化学习的透明液体倾倒。这提供了第三方尝试复用感知方法的具体实例;该项目目前标注为开发中。
-
语言引导抓取:将物体语义描述与完整六自由度位姿连接起来
早在 2022 年,这项工作就将自然语言定位与类别级完整六自由度位姿估计结合,用于真实机器人抓取。通过名称、属性与空间关系识别目标,再估计三维位置与姿态,支持抓取已知类别中的未见实例,将语义意图落实为物理操作所需的几何信息。IROS 2023 的细粒度指令抓取研究进一步发展这一方向,增强对目标物体属性的表达与定位。
独立团队的 MaskGrasp(IROS 2024)在语言驱动抓取的相关工作中引用这两篇论文。两项研究记录了团队在 2022–2023 年从语言意图理解到三维感知和动作执行的持续探索,并与 WALL-E、Polaris 的交互式机器人研究形成持续的研究脉络。
-
WALL-E:将 ChatGPT 多轮对话与 9D 视觉定位结合的先驱系统
据我们所知,WALL-E 是首个将 ChatGPT 多轮偏好对话与 9D 视觉定位相结合、用于真实机器人抓取的系统。首篇公开预印本于 2023 年 8 月 30 日发布。工作将 ChatGPT 的多轮偏好理解与 9D 视觉定位——6D 物体位姿和三维尺寸——结合,把对话中的用户意图转化为可执行抓取,并引入执行后的用户反馈,让后续交流能够结合最近一次动作的结果,将语言交互、空间感知与真实机器人控制连接起来。
入选得克萨斯大学达拉斯分校 CS 6301(2023 年秋季)课程项目指南的代表性参考文献,与 SayCan、Instruct2Act 一同列于“语言引导操作”主题。KAIST 研究者发表于《Intelligent Service Robotics》的大语言模型与智能机器人综述,也在物体定位部分引用该工作,讨论语言信息与视觉感知的连接。
-
Smart Bartender(智慧酒保):看懂你的眼神,就知道你想喝什么
我们的 Smart Bartender(智慧酒保)看懂你的眼神,就知道你想喝什么酒或饮料。用户只需注视目标饮料,机器人便通过眼动跟随识别所选瓶子,结合类别级物体位姿估计与运动规划,完成抓取和倒饮料,并泛化至训练时未见过的瓶子与杯子。
入选 IEEE Spectrum 的 Video Friday 栏目 ICRA 2023 机器人视频精选。该编辑精选收录了演示,并列明复旦大学团队及作者。
-
2023 年初:视觉引导机器人抓取、倒水与眼动交互
早在 2023 年 2 月,我的课题组已公开展示机器人抓取与倒水系统,结合类别泛化和六自由度位姿估计,将仅用合成图像训练的模型应用于真实场景,并通过眼动凝视实现饮料供应。复旦大数据学院报道记录了 的成果展示。
-
无需咬口器的自主核酸采样机器人
我与上海优复博合作研发核酸采样机器人,融合 AI 视觉感知与力控技术,无需咬口器等接触式定位辅助器材,自主完成口腔定位与咽拭子采样,在真实场景中开展采样环节无人值守的实际试用。
据我们所知,这是上海市 2022 年唯一真正投入实际使用的核酸采样机器人。
机器人在上海虹桥临空园区为员工提供日常采样服务。上海长宁现场报道、人民网转载记录了约 30 秒完成采样,以及员工连续多日使用的真实试用情况;报道同时记载了人工辅助消杀。
成果入选上海城市数字化转型成果,并在上海城市数字化转型体验馆展出。
-
SAR-Net/F2G-Pose:从形状学习到类别级 6D 位姿估计大模型
SAR-Net 提出以形状对齐与对称恢复为核心的类别级六自由度位姿和尺寸估计方法,让合成数据训练的位姿模型迁移到真实物体。通过类别模板对齐推断旋转、对称形状恢复估计位置与尺寸,降低对高成本真实位姿标注的依赖。Baxter 实验验证了对已知类别中未见实例的抓取;其位姿估计器还为后续 PourIt! 和 WALL-E 系统提供几何定位基础。
SAR-Net 的后续工作 F2G-Pose 将这一研究路线推进到基础模型驱动的类别级 6D 位姿估计。F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation(Jinyu Zhang、Haitao Lin、Jiashu Hou、Xiangyang Xue、Yanwei Fu,NeurIPS 2026)将视觉基础模型特征提升到三维几何空间,从 RGB-D 观测直接预测物体位姿、尺寸与完整形状。我们将开源据我们所知学术界最大的类别级 6D 位姿估计大模型。
被独立团队纳入 PACE(ECCV 2024)基准的类别级位姿评测。PACE 在复杂、杂乱的真实场景中比较包括 SAR-Net 在内的方法,并公开其预测结果供下载与复现,使这项研究成为后续检验位姿估计泛化能力的比较对象。
-
I Know What You Draw:开创由手绘物体内容指定目标抓取的方法
据我们所知,这是首个依据手绘物体草图所描绘的内容来指定目标并完成抓取的机器人方法。它把用户“画了什么”转化为抓取目标,为难以用语言描述物体的情形提供交互方式。方法以图结构保留笔画关系,支持从约 100 幅手绘样本学习,并在数据集与真实 Baxter 机器人上验证了草图意图到物理抓取的连接。
这项工作启发了丰田 Frontier Research Center 参与的 Sketch-MoMa(ICRA 2025),进一步探索用草图控制移动机械臂的导航与操作。
第一视角视觉与跨视角理解
-
EgoCross 挑战赛:推动跨域第一视角视频理解
我担任首届 EgoCross 挑战赛联合组织者,并共同署名挑战赛技术报告。该赛事于 EgoVis @ CVPR 2026 举行,面向手术、工业装配、极限运动与动物视角,评估跨域视频问答能力。
报告记录了超过 130 名参与者、超过 1,500 次提交,并公开挑战赛数据、基线代码与获胜团队方案。
-
ObjectRelator 与 V²-SAM:连接第一与第三视角
ObjectRelator(ICCV 2025)首次将文本模态引入第一—第三视角物体对应任务。通过多模态条件融合与物体级跨视角对齐,克服大幅视角变化带来的差异,识别并分割同一物体,将人眼所见与外部相机观察连接起来。
V²-SAM(CVPR 2026)首次实现 SAM2 在跨视角场景下的坐标点提示。方法结合几何与外观提示专家,通过循环一致性选择可靠预测,拓展基础分割模型处理跨视角物体对应的能力。
两篇论文均入选 Highlight。ObjectRelator 相关参赛方法还获 Ego-Exo4D 2025 挑战赛物体对应赛道第二名,该挑战赛于 CVPR 2025 的 EgoVis 工作坊举行。
-
EgoSound:首个系统评测多模态大模型第一视角声音理解能力的基准
EgoSound 是首个系统评测多模态大模型第一视角声音理解能力的基准。它结合 Ego4D 与 EgoBlind 的生活场景,以七类任务覆盖声音感知、空间定位、因果推断与视听联合推理,为利用声音和视觉理解相机佩戴者周围发生的事件提供专门的评测平台。
该工作入选 CVPR 2026 Highlight,并开放数据集与评测代码,推动第一视角智能从视觉理解走向多感官理解。
-
Whose hand is this? Person Identification from Egocentric Hand Gestures
Satoshi Tsutsui, Yanwei Fu, David Crandall
研究如何根据手部外观与运动识别第一视角相机佩戴者,并通过身份对抗训练提升手势识别的跨用户泛化能力。
脑解码与开放科研资源
-
开放脑信号数据:累计下载逾 18 万次
团队通过 Fudan-fMRI 持续向科研社区开放脑信号数据与研究资源,已发布 8 个公开仓库,累计下载逾 18 万次。其中 fMRI-Shape 单项累计下载逾 13 万次,其他资源包括 fMRI-Objaverse、fMRI-Video 和 CineBrain。
以上为 Hugging Face 的仓库累计下载统计,查询日期为 。
-
BSR-VideoMAE:开源 EEG 大模型,投稿时取得最优表现
BSR-VideoMAE 是我们提出的开源 EEG 大模型,已公开脑信号渲染、模型预训练与少样本适配代码。它将脑电频谱按电极位置渲染为保留神经拓扑的“谱视频”,引入 VideoMAE 的时空先验。据我们所知,该工作首次将“每名新受试者作为独立任务”的少样本适配用于检验 EEG 基础模型泛化,并首次提出显式区分预训练已见与全新电极的跨蒙太奇微调协议。
在论文投稿时的基准比较中,BSR-VideoMAE 在四个被试级少样本适配数据集、两个全数据微调数据集上,均取得所比较方法中的最佳表现(SOTA)。其中,SHU-MI 运动想象少样本适配达到 59.59% 平衡准确率,比所比较的最强基线提高 5.03 个百分点,体现了其对新用户校准与跨电极配置迁移的价值。
-
Spatiotemporal Neural Frames:EEG 引导的动态 fMRI 重建与中间帧补全
据我们所知,该工作首次将 EEG 引导的高空间分辨率 fMRI 序列建模,与无需再训练、保持已观测锚帧一致的中间帧重建(InterRecon),统一到扩散 Transformer 框架中。零空间约束支持补全任意中间位置的缺失帧,将 EEG 的时间信息与 fMRI 的空间细节相连接。
在 CineBrain 六名受试者的同步 EEG-fMRI 数据上,模型重建覆盖全脑 91,282 个灰质坐标的动态序列。重建结果还可输入 fMRI-to-video 解码器,恢复粗粒度场景语义与时间连续性,展示脑动态补全及下游视觉解码的研究价值。
-
CineBrain:CVPR Daily 封面报道与独立团队采用
首次系统探索融合 fMRI 与 EEG 进行视频重建,并登上周日刊封面,获五页专题专访与评述(第 10–14 页),介绍团队融合视听感知与多模态脑信号的脑解码研究。
开放数据集已支持独立团队的视频与语音重建研究。同济大学的 DynaMind(CVPR 2026)采用 CineBrain 开展 EEG-to-video 实验,并评价 Cine-Benchmark 对自然、以人为中心的视频评测更全面;NeuroSonic(MICCAI 2026)将其用于 EEG 条件下的语音重建。
脑机接口社区于 2026 年 7 月 8 日刊发 CineBrain 专题解读,全文收录于科技区角。
-
EEG-Graspbot:从脑电想象意图到机器人抓取与放置
双通道脑电意图接口连接“想抓什么”与“想放在哪里”:视觉想象识别目标物体,运动想象指定放置位置。离线训练的解码器处理实时脑电流,驱动真实 KINOVA GEN2 机械臂执行操作,将高层认知意图转化为物理动作。
这项 ICRA 2026 研究完成了健康受试者中的在线概念验证:5 名受试者参与离线实验,其中 4 名参与在线测试。论文报告端到端任务成功率为 20.88%,验证了系统可行性,也指出意图解码可靠性仍有提升空间。
团队的基于脑电意图解码的机器人智能抓取系统于 2025 年 6 月 5 日在复旦大学聚焦机器人技术与产业转化的闭门沙龙上展示,复旦大学技术转移中心于 6 月 6 日报道了这次展示。
-
fMRI 梦境解码:从睡眠脑信号到视觉叙事
团队探索利用 fMRI 解码梦境视觉意象,并结合语言模型构建视频叙事。
《Communications of the ACM》于 2026 年 5 月刊发专题报道并专访我,介绍梦境解码与 CineBrain 研究。研究亦获得 NASW / ScienceWriters 专访及 Innovando.News 专题介绍,Science and Fiction 则将论文解读与原创科幻故事相结合。
-
NeuroPictor:在独立评测中取得结构保真度第一
剑桥大学研究者 Weihao Xia 与 Cengiz Öztireli 的 AAAI 2026 论文在 NSD 数据集上比较了 14 种脑视觉解码方法,NeuroPictor 的结构保真度指标 BASIC-L 排名第一,得分为 25.88。
香港科技大学的 ZEBRA(NeurIPS 2025)沿用 NeuroPictor 的统一脑信号表征思路,并采用 fMRI-PTE 的预训练编码器,研究零样本跨受试者视觉解码。
-
MinD-3D / MinD-3D++:从首创脑到三维任务到纹理网格重建
本团队首次提出并定义 fMRI-to-3D(Recon3DMind)研究任务,开发 MinD-3D 框架验证从脑信号重建三维物体的可行性,并发布首个 fMRI–3D 形状配对数据集 fMRI-Shape,覆盖 14 名受试者。 预印本于 公开,发表于 ECCV 2024。
MinD-3D++(TPAMI 2025)将重建拓展到带纹理的三维网格,并开放 fMRI-Objaverse:覆盖 117 个类别的 3,142 个物体、5 名受试者,进一步支持三维物体几何结构与外观的解码和评测。
fMRI-Shape 的首创性与后续研究价值获得独立团队认可:Neuro-3D(CVPR 2025)明确将其称为首个 fMRI–3D 形状配对数据集;NeuroSculptor3D(AAAI 2026)与 BrainGS(CVPR 2026)将其用于脑到三维重建研究,其中 BrainGS 沿用 MinD-3D 的跨受试者、跨类别评测设置。BrainGS 还将 MinD-3D++ 作为三维重建比较基线;剑桥大学的 BASIC 研究(AAAI 2026)则独立评测其语义与结构保真度。
-
GLFA → DecoFuse:从跨受试者视频脑解码到“什么、哪里、如何运动”的分解重建
GLFA 提出全局—局部功能对齐,将不同受试者的 fMRI 信号映射到共享脑空间,并结合扩散生成器重建视频。团队同时开放 fMRI-Video 数据集,包含 8 名受试者约 75,000 个 fMRI–视觉刺激配对样本。
作为 GLFA 研究路线的后续工作,DecoFuse(2025)进一步将视频脑解码分解为“什么”(语义)、“哪里”(空间)和“如何运动”(运动),分别恢复后再融合生成视频。这种设计使各组成部分能够单独检验;差异神经编码分析还考察了其表征与大脑腹侧、背侧视觉通路的对应关系。
系列工作已进入独立研究的比较与评测体系。上海交通大学 MindCross(AAAI 2026)将 GLFA 选为代表性跨受试者视频解码框架,评测视频重建与新受试者适应;剑桥大学 BASIC(AAAI 2026)则将 DecoFuse 纳入 CC2017 视频脑解码评测,与 MinD-Video、NeuroClips 比较。
-
LEA:通过潜在表征对齐统一 fMRI 解码与编码
LEA 将脑信号与视觉刺激的潜在表征对齐,在统一的双向框架中,从 fMRI 重建视觉刺激,并从图像预测脑活动。研究于 2023 年 3 月首次公开,发表于 TMLR 2024 年 12 月,代码已开放。
加州大学伯克利分校 Lexin Li 教授团队的独立后续研究,以 LEA 的线性对齐思路为基础,推进统计脑编码与解码,并将 LEA 纳入实验比较(2026 年预印本)。Lexin Li 是伯克利生物统计学部主任、AAAS/IMS/ASA Fellow,并担任 Annals of Applied Statistics 主编(2025–2027)。
NeuroSculptor3D(AAAI 2026)也评测了 LEA-3D 适配方法,并明确使用官方代码重新计算基线结果。
-
fMRI-PTE:大规模、多受试者 fMRI 预训练大模型
据我们所知,fMRI-PTE 是首个以约 4 万名受试者进行大规模预训练、面向跨受试者视觉脑解码的 fMRI 大模型。模型利用 UK Biobank 的 39,630 名受试者数据进行预训练,学习共享神经表征,支持受试者内及跨受试者视觉解码。
本团队于 公开 arXiv 预印本。
2024 年 8 月,《科技日报》将付彦伟团队完成的成果称为“学术界首个功能性磁共振成像预训练大模型”。报道指出,这项进展为解码记忆与梦境中的视觉想象奠定基础;人民网与央广网转载了同篇报道。
Disney Research 时期的研究
-
融合物体与场景语义,理解复杂视频事件
报道 Disney Research 与复旦的合作成果,探索视频理解以及对训练样本之外的新事件的识别。
奠基性工作
-
2020–2024统计稀疏性与学习
one-shot learning and statistical sparsity
以统计稀疏性为共同线索,连接小样本学习中的可信伪标签推断、噪声标签下的干净样本选择与深度网络稀疏结构学习。
小样本学习 · CVPR 2020
Instance Credibility Inference for Few-Shot Learning
Yikai Wang, Chengming Xu, Chen Liu, Li Zhang, Yanwei Fu
期刊扩展版 · TPAMI 2022
How to Trust Unlabeled Data? Instance Credibility Inference for Few-Shot Learning
Yikai Wang, Li Zhang, Yuan Yao, Yanwei Fu
通过稀疏统计建模识别可信伪标签,利用未标注数据提升小样本学习;期刊扩展版进一步引入广义线性模型与理论分析。
噪声标签学习 · CVPR 2022
Scalable Penalized Regression for Noise Detection in Learning With Noisy Labels
Yikai Wang, Xinwei Sun, Yanwei Fu
期刊扩展版 · TPAMI 2024
Knockoffs-SPR: Clean Sample Selection in Learning with Noisy Labels
Yikai Wang, Yanwei Fu, Xinwei Sun
利用 Knockoff 滤波器筛选干净训练样本,并在理论假设下控制误选率。
统计学习基础 · ICML 2020
DessiLBI: Exploring Structural Sparsity of Deep Networks via Differential Inclusion Paths
Yanwei Fu, Chen Liu, Donghao Li, Xinwei Sun, Jinshan Zeng, Yuan Yao
期刊扩展版 · TPAMI 2023
Exploring Structural Sparsity of Deep Networks Via Inverse Scale Spaces
Yanwei Fu, Chen Liu, Donghao Li, Zuyuan Zhong, Xinwei Sun, Jinshan Zeng, Yuan Yao
通过逆尺度空间动力学学习神经网络的稀疏结构;期刊扩展版进一步研究自适应网络生长与稀疏子网络迁移。
-
2023–2025因果学习
因果学习:未观测混杂与可靠泛化
在重要混杂因素未被观测时,学习因果效应与因果关系。这一研究主线连接连续干预估计、基于代理变量的因果发现与因果特征学习,既研究“干预会使结果改变多少”,也研究“何时能从观测证据识别因果关系”,贯通识别理论、可实施的估计方法,以及视觉识别和医学预测应用。
连续干预的因果估计 · ICLR 2024
Doubly Robust Proximal Causal Learning for Continuous Treatments
Yong Wu, Yanwei Fu, Shouyan Wang, Xinwei Sun
将双重稳健近端因果估计从二元决策推进到连续干预,例如不同治疗剂量。通过核平滑构造可计算的估计器,给出桥函数估计方法与误差分析;在框架假设成立时,双重稳健性质允许其中一类桥函数发生模型误设。
基于代理变量的因果发现 · ICML 2025
Bivariate Causal Discovery with Proxy Variables: Integral Solving and Beyond
Yong Wu, Yanwei Fu, Shouyan Wang, Xinwei Sun
提出保留连续变量信息、利用超出一阶矩的分布关系进行检验的非参数方法;揭示单一代理变量积分检验何时会漏掉真实因果关系,并引入第二类代理变量构造额外约束,在相应条件下恢复识别。
相关应用包括以 PatchMix(TPAMI 2023) 将因果特征学习用于小样本识别,以及以 Causally-Aware Intraoperative Imputation(CVPR 2023) 将术中信息融入术前生存结局预测。
第三方评价与独立研究采用
Arthur Gretton · CLeaR 2026 大会主旨报告。其关于未观测混杂调整的主旨报告材料将本团队 ICLR 2024 方法列为双重稳健代理因果学习方法之一,与 Cui 等人的二元干预框架并列介绍,并概括其基于密度比与核平滑的连续干预形式(幻灯片 19/32)。
Bozkurt、Zenati、Meunier、Xu 与 Gretton · NeurIPS 2025。Density Ratio-Free Doubly Robust Proxy Causal Learning将本团队 PKDR 纳入
recent state-of-the-art PCL algorithms
,即近期先进的近端因果学习算法。正文明确介绍其将双重稳健估计拓展到连续干预的贡献,使用原实现作对照,并沿用本团队的合成数据生成过程开展实验(第 1、5 节)。Meng、Brahma、Henao 与 Carin · 杜克大学,AISTATS 2026。Neural Doubly Robust Proximal Causal Estimation将本团队工作与其他相关研究共同列为提升近端因果方法稳健性、灵活性与现实问题适用范围的进展,在引言中讨论了其在未观测混杂下可实施因果估计方法发展中的位置。
Ham、Wu 与 Cui · 2026 年统计推断预印本。Debiased inference for proximal dose-response function以
Closest to our setting
(与其研究设置最接近的工作)引出本团队 ICLR 2024 论文,具体讨论核估计器及偏差—方差分析,并将其作为直接理论比较对象,进一步发展标准误、置信区间与同时置信带(引言)。Chen、Pan 与 Shen · 明尼苏达大学,2026 年预印本。Proxy-Adjusted Causal Discovery from Targeted Interventions在非参数代理变量因果检验的前序研究中讨论本团队 ICML 2025 论文,并将这一研究方向与其他代理方法共同视为:在适当识别条件下,利用代理信息开展灵活统计推断的可行路径。
Zuo 等人 · PatchMix 独立采用,CMC 2025。Federated Learning and Optimization for Few-Shot Image Classification将 PatchMix 用于联邦小样本学习,认为它通过增加数据多样性帮助模型学习更稳健的特征。其消融实验显示,加入 PatchMix 后,MiniImageNet 的单样本分类准确率由 56.62% 提升至 58.14%,TieredImageNet 由 58.48% 提升至 60.67%(第 5.4.2 节、表 2)。
-
2012–2020零样本学习
零样本学习:从多模态属性到开放集识别
据我们所知,ECCV 2014 / TPAMI 2015 工作首次明确提出零样本学习中的投影域偏移(projection domain shift)问题,并通过传导式多视图嵌入加以缓解。后续独立研究明确将这一问题的提出归于该工作。
这一系列涵盖早期属性驱动的视频识别与 USAA 数据集、多标签零样本学习,以及利用语义词汇连接有监督、零样本与开放集识别的词汇驱动学习。
面向未见类别的属性学习 · ECCV 2012 / TPAMI 2014
Attribute Learning for Understanding Unstructured Social Activity
Yanwei Fu, Timothy M. Hospedales, Tao Xiang, Shaogang Gong
Learning Multimodal Latent Attributes
Yanwei Fu, Timothy M. Hospedales, Tao Xiang, Shaogang Gong
传导式多视图学习 · ECCV 2014 / TPAMI 2015
Transductive Multi-view Embedding for Zero-Shot Recognition and Annotation
Yanwei Fu, Timothy M. Hospedales, Tao Xiang, Zhenyong Fu, Shaogang Gong
Transductive Multi-view Zero-Shot Learning
Yanwei Fu, Timothy M. Hospedales, Tao Xiang, Shaogang Gong
多标签零样本识别 · BMVC 2014
Transductive Multi-label Zero-shot Learning
Yanwei Fu, Yongxin Yang, Timothy M. Hospedales, Tao Xiang, Shaogang Gong
词汇驱动学习 · CVPR 2016 / TPAMI 2020
Semi-supervised Vocabulary-informed Learning
Yanwei Fu, Leonid Sigal
Vocabulary-informed Zero-shot and Open-set Learning
Yanwei Fu, Xiaomei Wang, Hanze Dong, Yu-Gang Jiang, Meng Wang, Xiangyang Xue, Leonid Sigal
招生与学术访问
欢迎围绕以上研究方向开展合作。科研交流、博士申请或暑期访问,请联系 yanweifu@fudan.edu.cn;也欢迎有意开展暑期实习的国际学生联系。
2026 年招生说明:本组仅在复旦大学大数据学院和上海创智学院招生。大数据学院科学硕士及直博生由学院统一招生,请先申请并获得学院 offer,再联系我;申请普博或暑期访问可提前联系。有兴趣研究统计稀疏性的本科生,也可联系孙鑫伟老师共同合作。
本组 2026 年入学的硕士名额已满。
美国专利
复旦大学与 Disney Research 时期的美国授权专利,涵盖三维视觉、图像修复与视觉识别。以下列出 11 个授权号,相关延续申请合并展示。
复旦大学 原始受让人
-
姿态与尺寸估计网络与系统
Network and system for pose and size estimation
Yanwei Fu, Haitao Lin, Xiangyang Xue
-
图像修复系统与方法
System and method for image inpainting
Yanwei Fu, Chenjie Cao
-
神经姿态迁移网络与系统
Network and system for neural pose transfer
Yanwei Fu, Xiangyang Xue, Yinda Zhang, Chao Wen, Haitao Lin, Jiashun Wang, Tianyun Zou
-
图像处理网络、系统与方法
Network, system and method for image processing
Yugang Jiang, Yanwei Fu, Changmao Cheng, Xiangyang Xue
-
基于形变的多视图三维网格生成
Network, system and method for multi-view 3D mesh generation via deformation
Yanwei Fu, Chao Wen, Yinda Zhang, Zhuwen Li
-
三维形状生成网络、系统与方法
Network, system and method for 3D shape generation
Yugang Jiang, Yanwei Fu, Nanyang Wang, Yinda Zhang, Zhuwen Li
Disney Enterprises, Inc. 原始受让人
-
基于预条件 Lasso 与直推扩散成分分析的鲁棒分类
Robust classification by pre-conditioned lasso and transductive diffusion component analysis
Yanwei Fu, Leonid Sigal
-
词汇知识引导的数字内容分类
System and method of vocabulary-informed categorization of items of interest included within digital information
Yanwei Fu, Leonid Sigal
-
融合物体与场景信息的活动及事件识别
Systems and methods for identifying activities and/or events in media contents based on object data and scene data
Zuxuan Wu, Yanwei Fu, Leonid Sigal
已公开美国专利申请
申请人:腾讯科技(深圳)有限公司
-
三维图像生成
Three-dimensional image generation
Shijie Zhang, Chengming Xu, Junwei Zhu, Xuelin Qian, Ying Tai, Yanwei Fu, Chengjie Wang
US20260245287A1 ↗ · 公开于